ESSAYS / Products & Technology
Jev 之后,人工智能还有哪些可能?
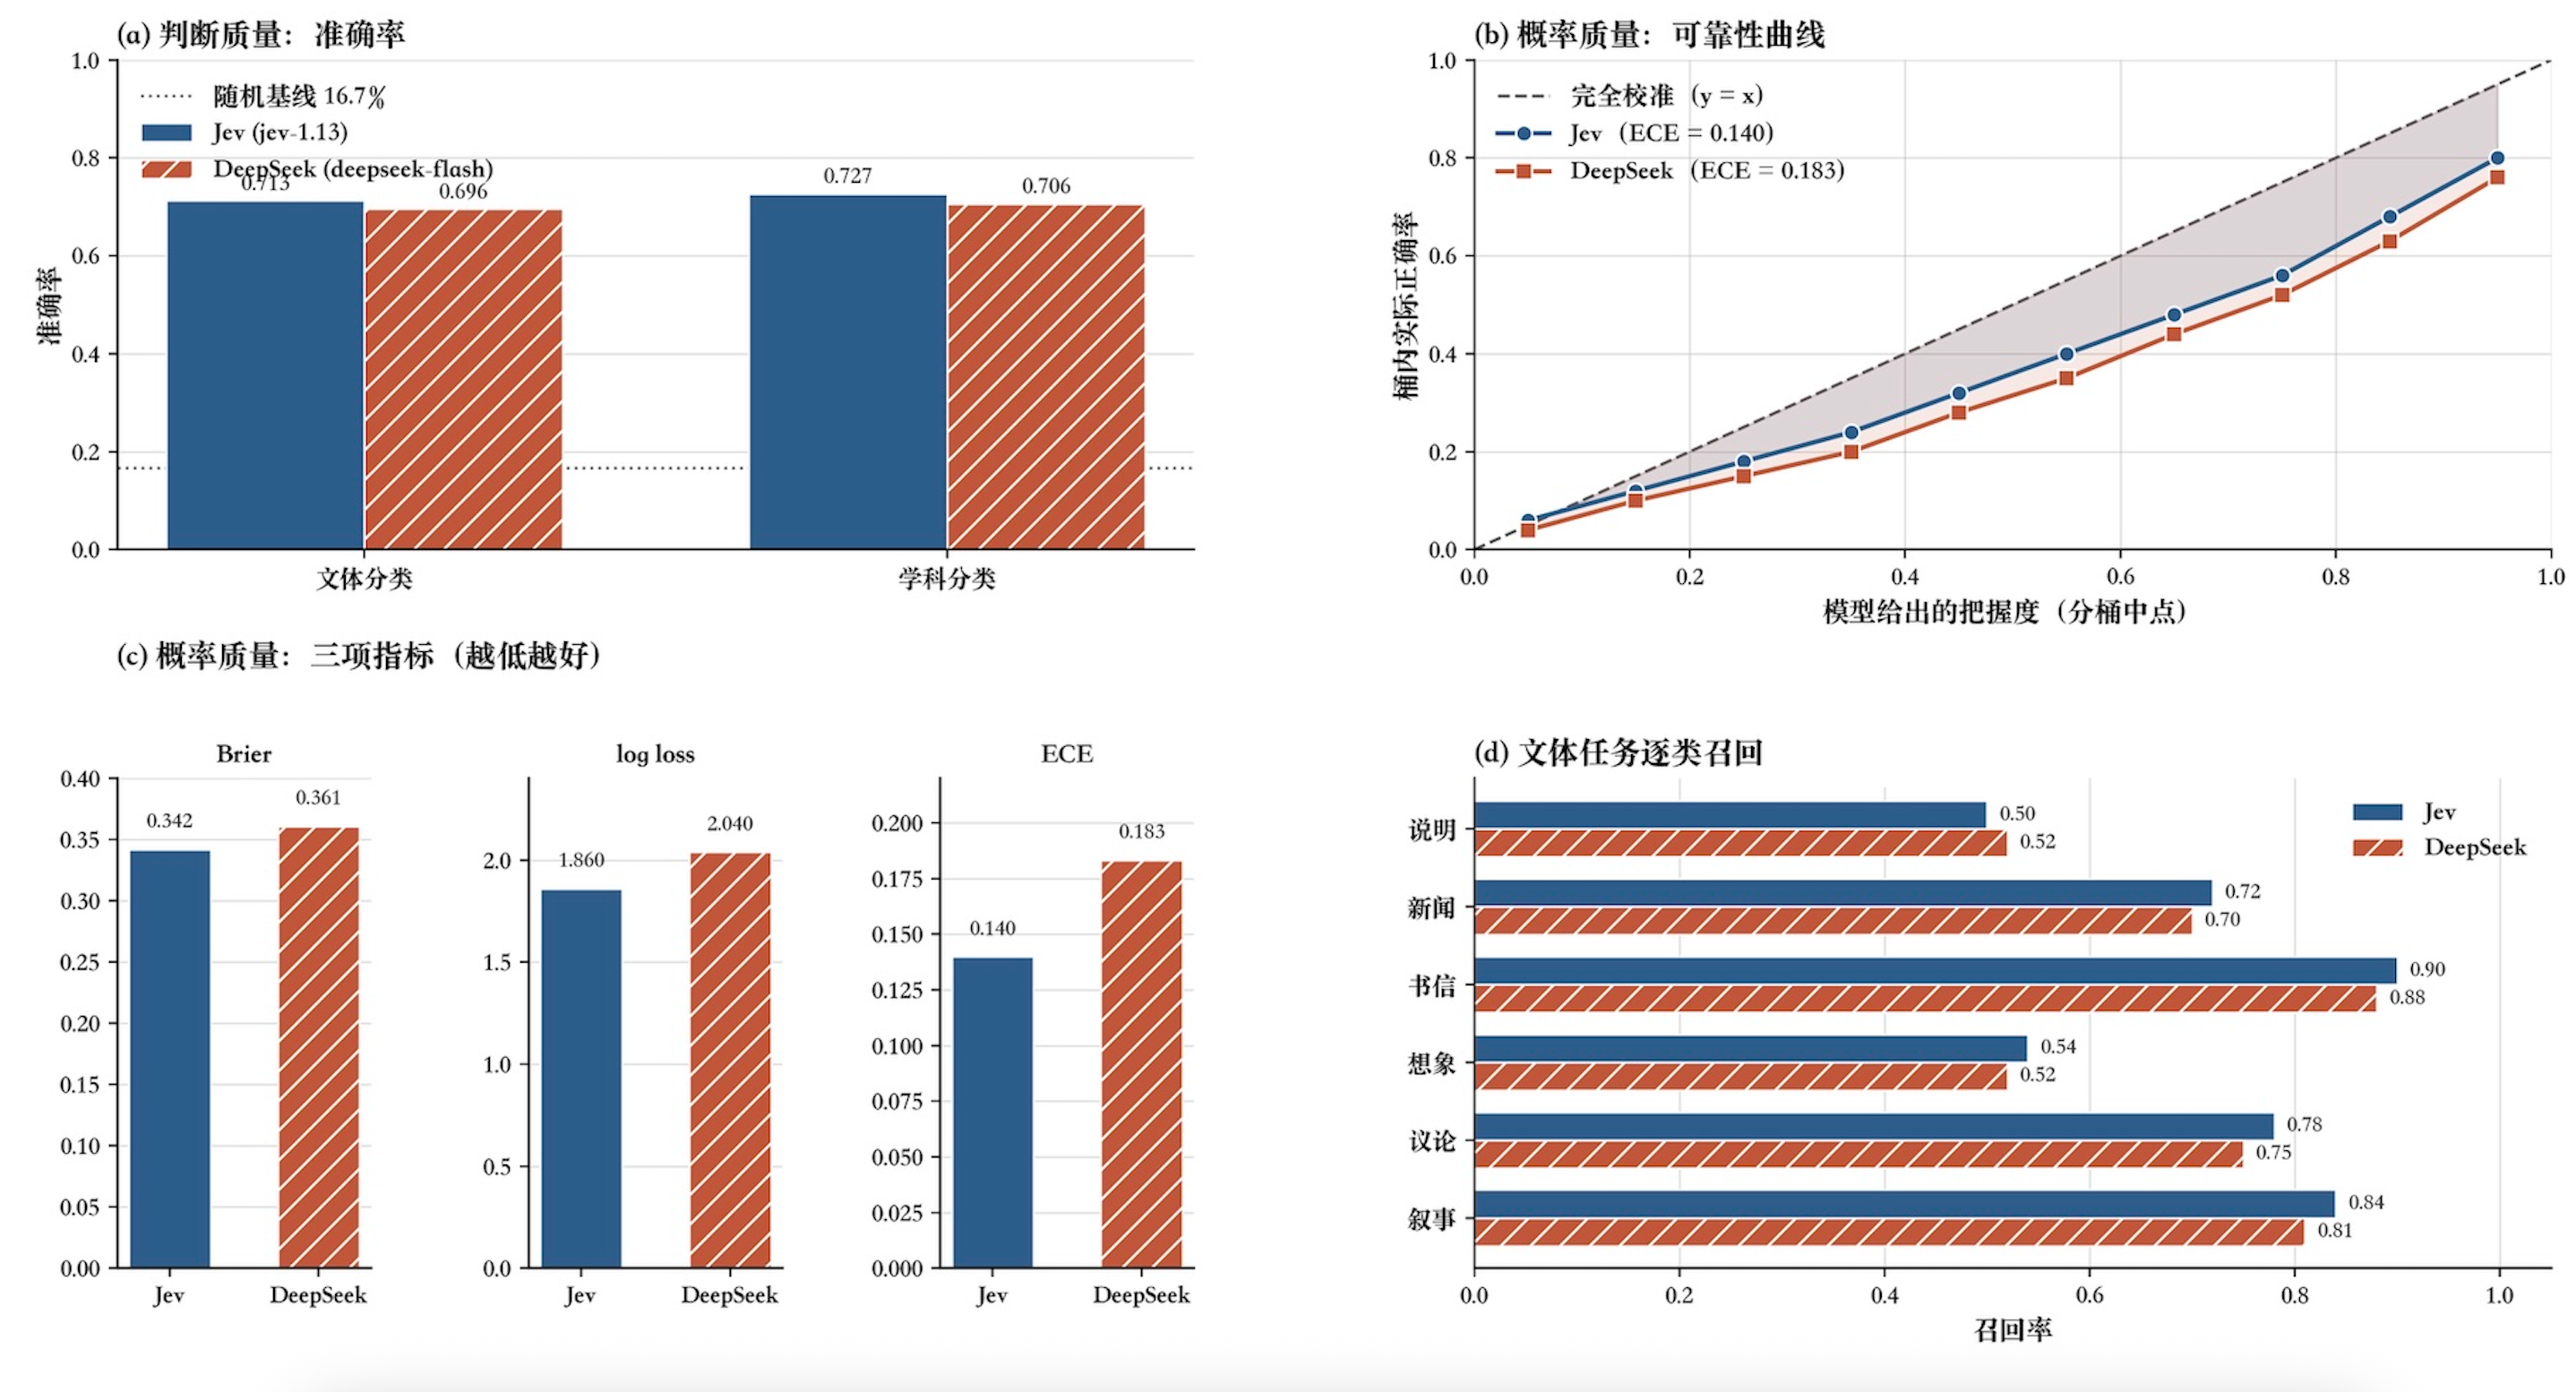
Jev 最近引起了很多讨论,我用767篇属于不同类型(如叙事、论述、想象)和学科领域(如物理、化学、历史)的文字切片,测试它能否把文字切片准确地分到对应的分类里去。
从结果来看 Jev 和 DeepSeek V4.1 Flash 的判断质量差不多,但延迟和成本小得多。结果不算非常惊艳,却引发了我对于「智能的形式」这一问题的进一步思考。
这几个月,越来越多的人在用小模型做任务。原因有两条: 第一,很多场景用不着大模型的深度思考和长篇输出,小模型的生态位本来就存在; 第二,深度思考和长篇输出有时候反而效果更差,大模型在简单任务上的过度推理会引入不必要的错误。
看起来像在开倒车。最早的机器学习就是在做分类器,后来有了大语言模型,怎么现在又回到分类器了?
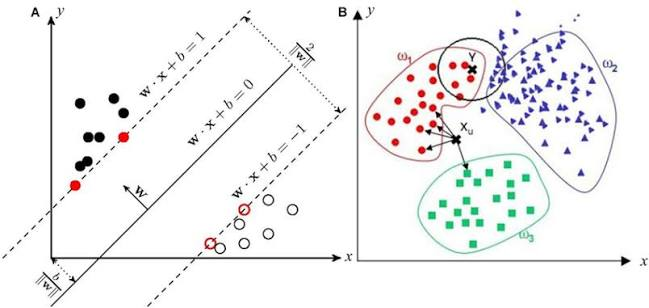
图:以 SVM 和 KNN 为例的传统分类器示意图。
Jev 给了一个更根本的回答。它不做逐 token 的文本生成,而是直接输出结构化的结果。在架构上,它只做 prefill,不做 decode,直接取所有可能的选项里概率最大的那个。
这个架构选择既是一个工程上的提醒(对于判断类任务,你不需要 decode 和逐 token 输出),也是一个方向上的提醒:逐 token 输出自然语言,可能本来就不是智能的唯一形式。
如果把智能等同于语言输出,那 Jev 确实是在开倒车。但如果智能可以有多种形式,那 Jev 只是选择了其中一种更适合判断任务的形式。
本文试图从表征(representation)的结构出发,探讨一个基本问题:智能可以以什么样的形式展现?除了 LLM 之外的选择是什么?
LLM 有什么缺陷?
LLM 的输出过程分为两步,先prefill处理整个输入,在模型内部建立一个高维的表征向量,再decode,从概率分布中采样出一个 token,把它拼回输入序列,模型再进行运算吐下一个 token。
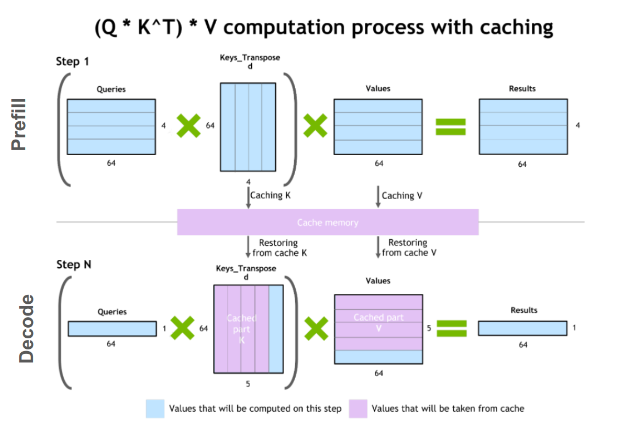
图:LLM 的 prefill / decode 流程示意。
这里有一个固有的带宽压缩。模型的词表大小通常在 32,000 到 200,000 之间,一个 token 携带的信息量约 15 到 18 bits。而模型每一层的隐藏状态有数千到数万个维度,每个维度是一个浮点数。内部表征的带宽比输出带宽高出几个数量级,不管模型多大,每次只能输出一个 token 的机制始终不变。
这个结构约束直接导致了一个表现上的问题。逐 token 采样优化的目标是下一个词在统计上最合理,它可以在微观上选用很合理的词句,但是整篇看下来不成立。
当然,RL 已经在解决这样的问题并取得了不错的效果,我想指出的是另一个问题:LLM 很多时候不知道自己其实不知道一些事情,也没有任何的机制能够让它知道,不管用什么样的harness。
这个缺陷在做事的时候不明显,因为工作任务的目标和约束是相对清晰的,但是在探讨问题和「思考」时非常明显。在并没有完全理解我的背景、我的真实处境和全部 context 时,它不懂得怎么问出好的 clarifying questions,并会输出一些看起来漂亮但并不符合我的真实情况的建议。
直观上看,它像一个只有 6 岁的天才宝宝,解数学题非常聪明,但对这个世界的真实情况一无所知,哪怕我已经给了它我以为很充分的context。能说出漂亮的、自圆其说的、看得过去的话,里面却缺少对现实情况的了解、缺少真实的有洞见的建议。这是不是「语言」模型的本质问题?
LLM 的训练数据是人类自然语言文本。自然语言本身是对现实世界的一种投影,LLM 在这个已经有损的语料上训练,学到的是语言世界的统计规律。这个过程可以表示为一条链:现实世界 → 自然语言 → 模型内部表征。第一步的损失取决于语言对现实的表达能力,第二步的损失取决于模型的容量和训练方法。
增加参数量和训练数据可以减少第二步的损失(让模型更好地学习语言中已有的信息),但第一步的损失不会因此改变(语言中本来就没有的信息,再多的参数也学不到)。所以存在一类智能任务,LLM 原则上无法做好,无论它有多大。
什么样的任务属于这一类?为什么?回答这个问题需要先弄清楚智能可以有哪些形式,以及这些形式之间的关系。
智能的不同表征形式之间,有什么差别?
举个例子。P = 猫在桌子上。¬P = 猫不在桌子上。这个否定操作在语言中简单到不需要思考,加三个字就完成了。
现在换成图像。画一张图 P’,内容是一只橘猫蹲在木桌中央。¬P’ 是什么?可以画猫在地上、在床上、在桌子旁边,但每一张都不是 ¬P’ 的完整表达。
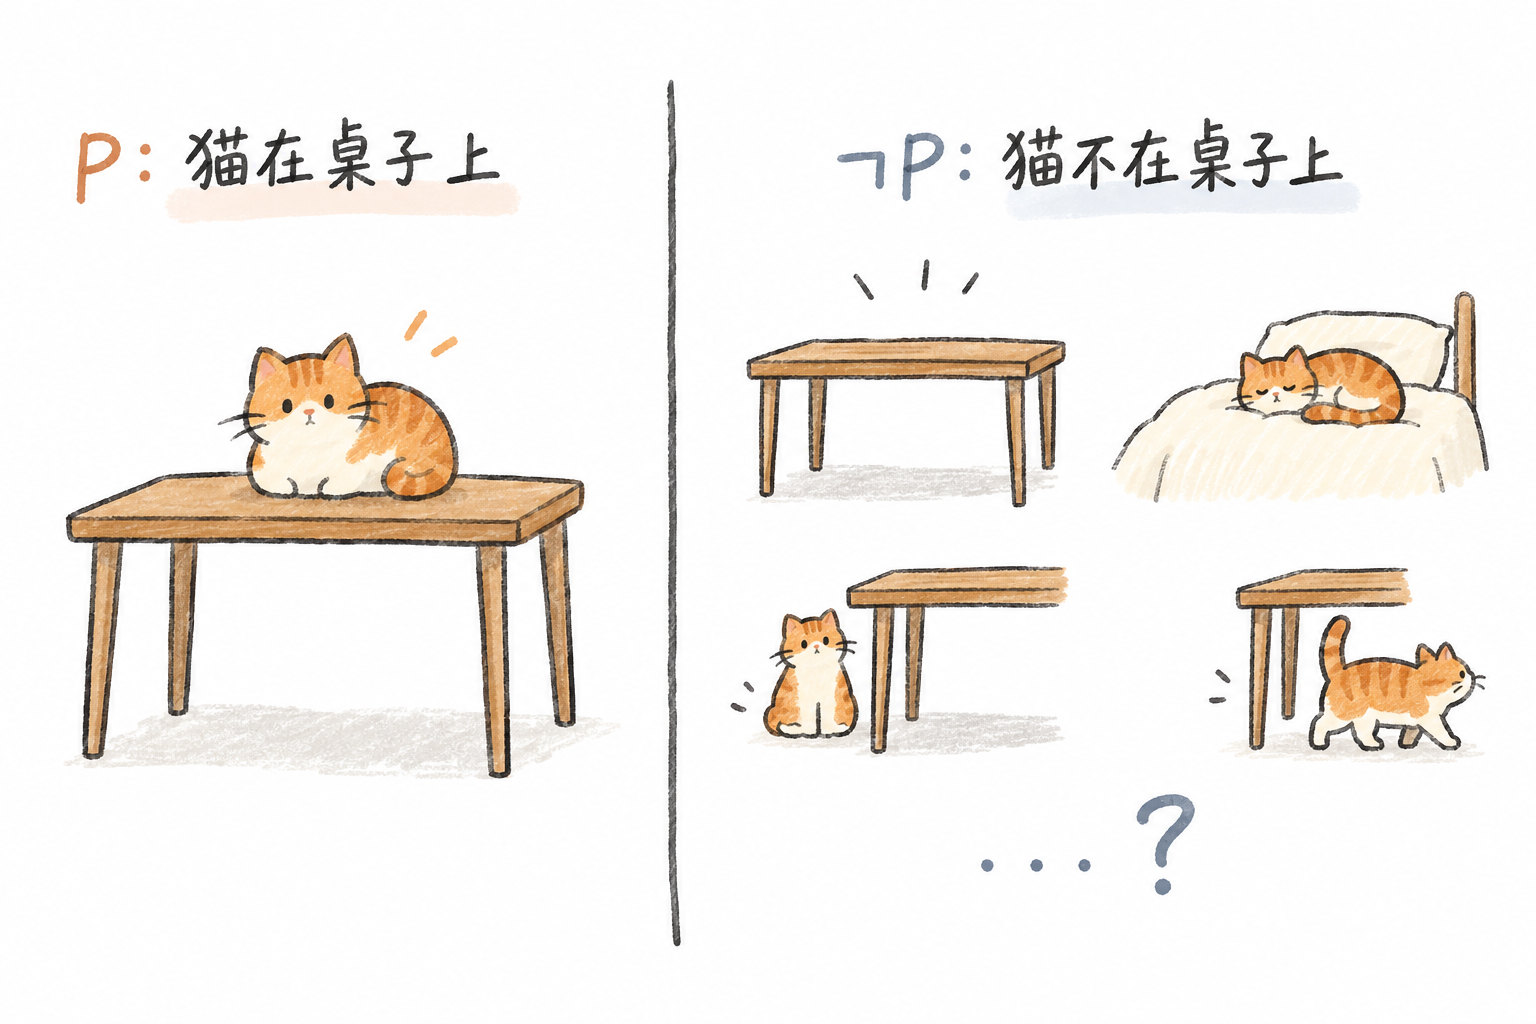
图:猫在哪里?
原因在于图像是过度指定的(over-specified)。要画出猫在桌子上,就不得不同时呈现猫的大小、姿态、颜色、桌子的材质和位置、周围的环境。这些细节中任何一项的变化都产生一张不同的图,而它们全部都满足猫在桌子上这个命题。对 P’ 做否定,就需要同时处理所有这些连续的维度,而否定在这些维度上没有唯一的定义。
反过来看。一张图中三个物体的空间关系(A 在 B 左边,B 在 C 上面,A 和 C 不接触)在图像中一眼就能看到,三个关系同时呈现,不分先后。用语言描述同样的信息,需要逐对列举,而且列举完之后读者仍然需要在脑中重建空间布局才能判断 A 和 C 之间的位置关系。语言能做到,但效率极低,而且重建过程本身依赖视觉空间能力。
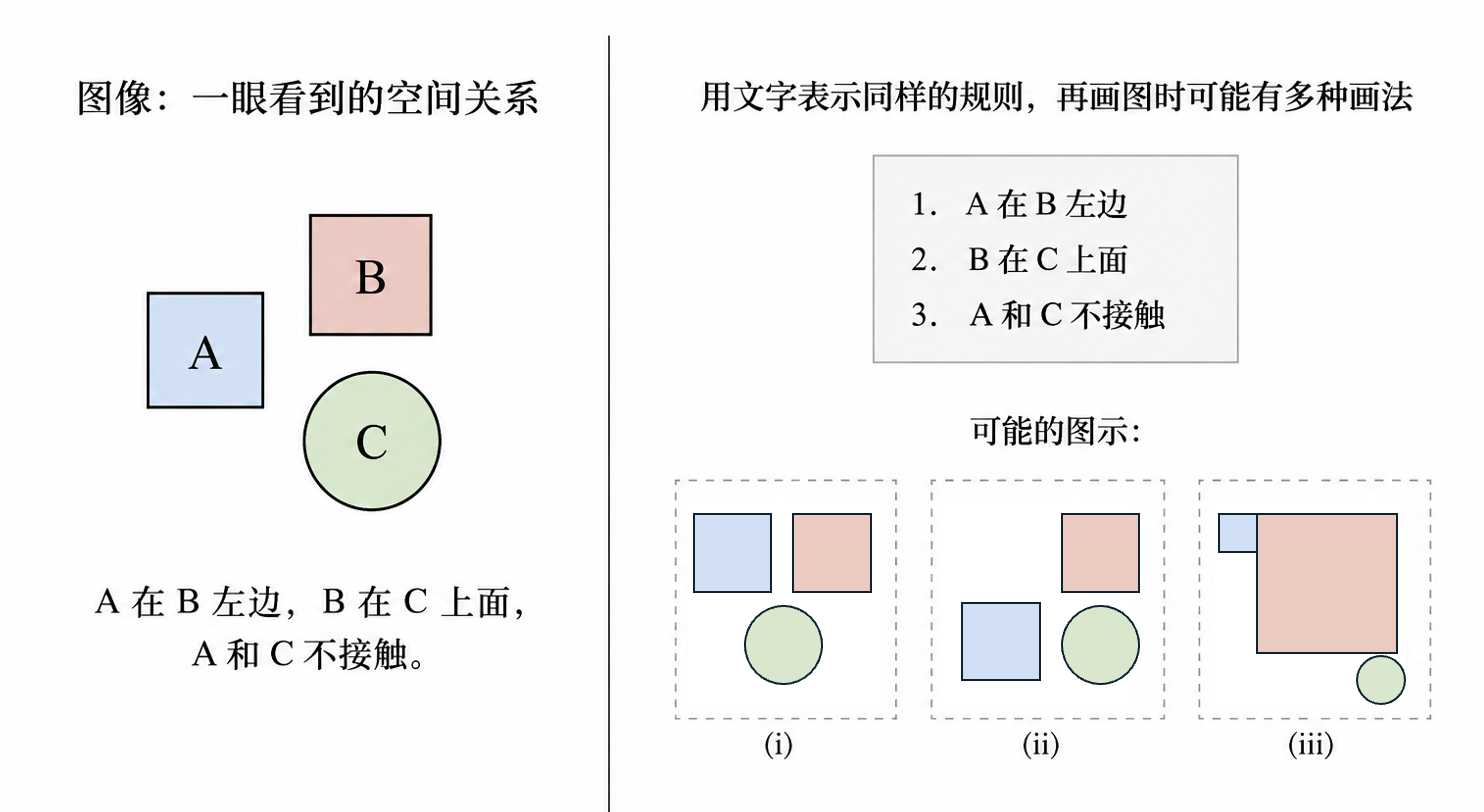
图:三个几何形的空间关系。
这个例子揭示了一个结构性的差异。语言能做否定,因为它的符号之间有明确的间隔(在/不在是两个离散的状态)。图像不能做干净的否定,因为它的表征是连续的。图像能直接呈现空间关系,因为它的物理属性同时在场。语言不能高效地呈现空间关系,因为它只能逐个陈述。
Goodman 在 1968 年的《艺术的语言》中区分了两种符号系统的结构性质,为上面的观察提供了精确的理论基础。
分节性(articulation):符号之间是否有明确的间隔。自然语言和逻辑系统是高度分节的。字母 a 和 b 之间有明确的界限,命题 P 和 ¬P 之间有明确的对立。分节性使得否定、析取、合取等逻辑操作成为可能,因为这些操作依赖于符号之间清晰的离散边界。
致密性(density):一个表征中有多少物理属性是语义相关的。一幅绘画是致密的:颜色的微小差异、线条的粗细、构图的空间关系都携带意义。一个句子是稀疏的:字体的大小、行距的宽窄通常不改变句子的意义。
猫在桌子上的例子正好对应这个区分。语言能做否定,因为它是分节的。图像不能做干净的否定,因为它是致密的。图像能直接呈现空间关系,因为致密表征允许所有属性(距离、大小、颜色、材质)必须都在。语言不能高效地呈现空间关系,因为分节表征要求逐个陈述。
从致密系统到分节系统的转换必然丢失信息。当你把一幅画翻译成一段描述时,丢失的是整个致密维度。反过来,把一段描述画成一幅画时,必须补上语言没有指定的所有致密属性(猫的颜色、桌子的材质),这些补充内容是画者的选择,不是原文的信息。
这个限制不能通过增加数据来解决。它来自表征格式本身的结构约束,和数据量无关。如果是这样,那我做出如下假设,没有任何一种格式可以承载所有智能操作,也就一定存在 LLM 之外的机器智能形式。
既然这样,智能还有哪些必要的形式?
这个问题的思想史远比 AI 时代久远,比如,Kahneman 的双重过程理论区分了 System 1(快速、自动、非语言化)和 System 2(慢速、刻意、语言化),这也是 Jev 在推出时着重强调的点。
在这里,我先指出三种有理论支撑的智能形式,它们不一定完整,但反映了智能的不同侧面。
1. 判断
可以用一个更火的词来代替:品味。品味的定义从 18 世纪就开始,休谟在《论品味的标准》中这样下定义:「感官精细到不放过任何成分,同时精确到能感知构成中的每一个要素」。没有这种辨别力的人只能察觉粗糙的、表面的特征,细微处全部被忽略。
品味不等于主观偏好。休谟区分了两件事:美确实是主观感受(sentiment),但对美的辨别有高低之分。一个训练有素的品酒师能尝出年份和产区,一个普通人只尝到好喝和不好喝。两人的感受都是真实的,但品酒师的辨别力更高。这种辨别力可以通过练习、比较和经验积累来提升。这是一种人类智能。
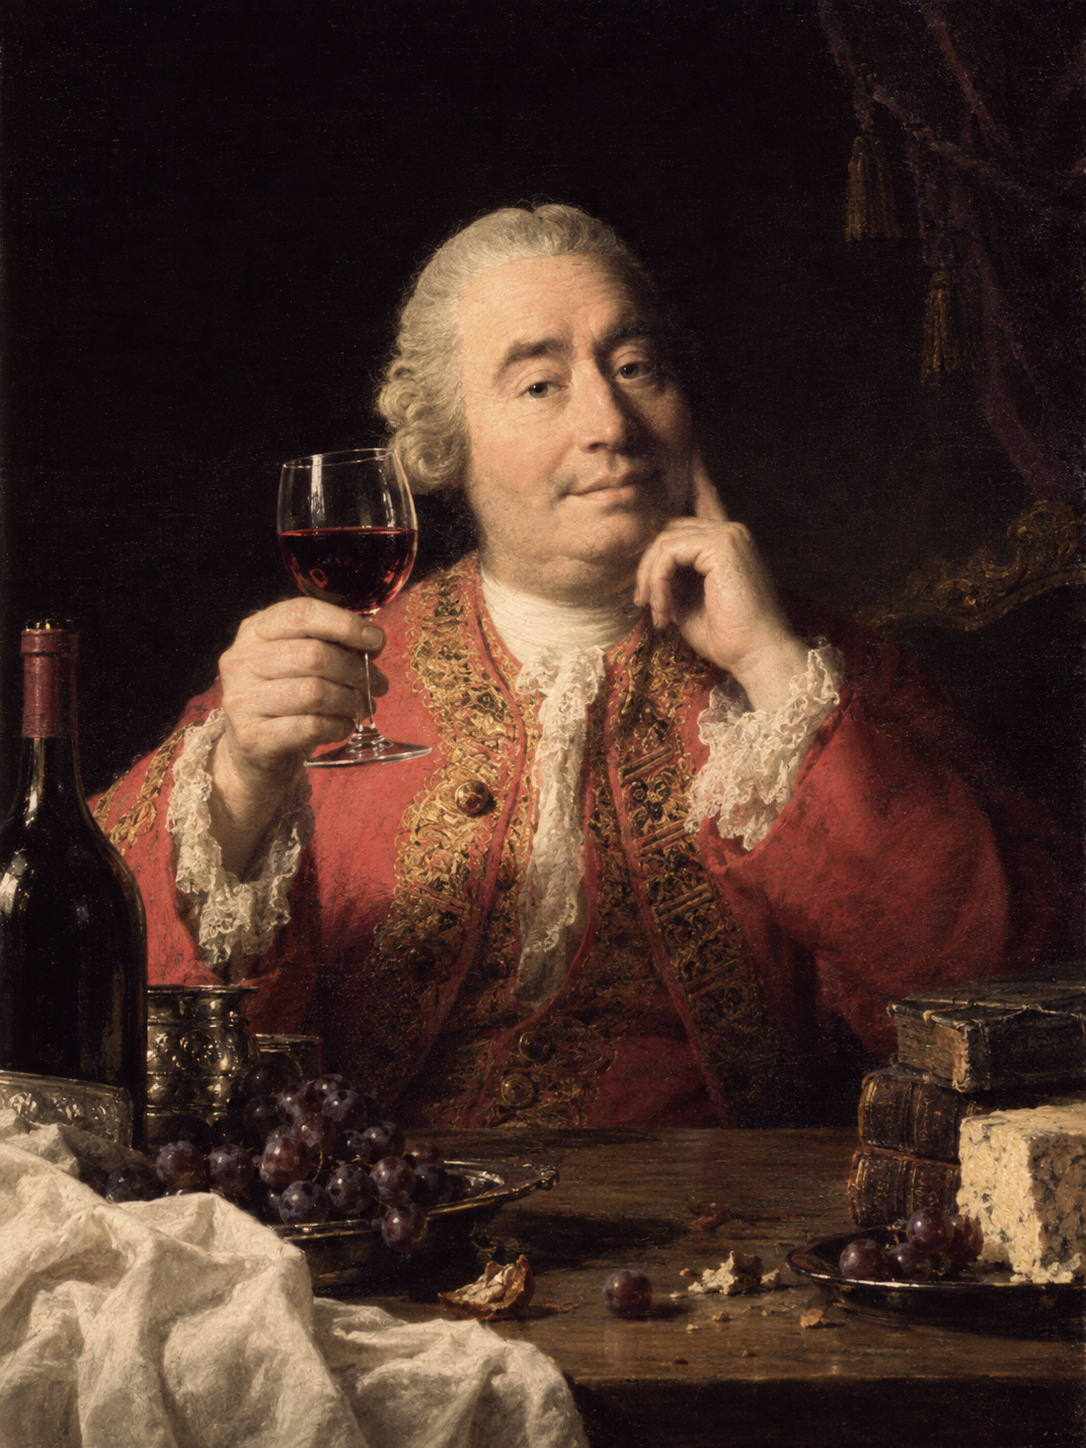
图:我能品出酒里的木桶味,你能吗?
品味,或者判断,就是在给定的输入中辨别出相关的特征,并对这些特征做出评估。判断的对象可以是一篇文本属于哪个类别、一个方案的风险等级、一个论证是否成立。品味的对象可以是一首曲子的演奏质量、一道菜的调味是否平衡。共同点是:这是一种不依赖逐步推理的直接辨别能力。
康德在《纯粹理性批判》中区分了两种判断:规定性判断(determinant judgment,把已知的规则应用于具体案例)和反思性判断(reflective judgment,为一个具体案例寻找适用的规则)。规定性判断对应的是:给定类别定义,判断一篇笔记属于哪个类别。反思性判断对应的是:读完一批笔记后发现一个全新的分类维度。前者是 Jev 目前在做的事,后者超出了它的能力。
Jev 的 prefill-only 架构直接对应了规定性判断的一个子集:给定选项的单步分类。它把所有候选项拼在输入后面,一次 prefill 计算每个选项的概率,取最大的。输出是一个概率分布,不是一段文本。
TypeSafe 用 RLCD(Reinforcement Learning for Calibrated Decisions)训练 Jev。RLHF 的奖励函数衡量的是人类觉得哪个回答更好,RLCD 的奖励函数衡量的是模型给出的置信度和实际正确率是否一致。
RLCD 训练的就是判断能力本身:让模型的自信程度和它实际做对的比例对齐。RL 的奖励函数在训练的是一种辨别力和偏好。休谟定义的品味训练(通过练习和比较来提升辨别力)和这在结构上完全相同:都是通过反复评估来校准主体的判断标准。
当 Jev 输出 confidence = 0.8 时,这串字符从自然语言的角度看什么信息都没有。但从判断的角度看,you have to mean it。0.8 意味着在所有 Jev 给出 0.8 置信度的案例中,大约 80% 应该是对的。如果实际只有 50% 是对的,这个 0.8 就是假的。RLCD 的训练目标就是消除这种偏差。
在我用自己知识库做的分类实测中,Jev 的准确率是 0.586,和DeepSeek 持平,但两个系统在概率质量上有明显差距。Jev 加上原子信号合成后的 ECE(Expected Calibration Error,预期校准误差)是 0.205,DeepSeek 是 0.350。延迟方面,Jev 的 p50 是 293ms,DeepSeek 的 p50 是 1314ms,Jev 快约 4.5 倍。
判断准确率持平,概率质量 Jev 更好,速度快一个数量级。这个结果说明:对于分类判断这个特定任务,逐 token 生成确实是不必要的开销。模型可以在内部表征空间中完成计算,直接输出概率分布。
但 Jev 目前覆盖的只是判断中最基础的子集。多步推理(从 A 推出 B 再推出 C)、条件推理、反事实推理这些更复杂的操作,prefill-only 的架构不支持,因为它们需要中间状态的维护和链式计算,一次 prefill 无法提供这种深度,我们需要多步骤的智能——逻辑。
2. 逻辑
这一类智能的核心能力是:基于判断给出的条件和命题,进行组合与推理。判断是辨别,逻辑是在辨别结果之上的组合,它要做到:既不过度发散,又不过度谨慎。
逻辑独立于自然语言这个想法有很长的历史。柏拉图在《理想国》和《斐多》中论证了理念的独立存在。数学真理和逻辑关系存在于一个独立的理念世界中,不依赖于物理世界,更不依赖于人类语言。我们说的三角形内角和等于 180 度,指向的不是任何一个画在纸上的具体三角形(那总是有误差的),而是三角形的理念本身。从柏拉图的角度看,逻辑和数学是对理念世界的把握,自然语言对逻辑的表达是一种有损投影。
这种损失是可以具体指出的。逻辑量词 ∀x(对所有 x)和 ∃x(存在某个 x)是精确的,没有歧义。但自然语言中的量词有系统性的模糊。「每个学生都读了一本书」至少有两种逻辑解读:所有学生读了同一本书(∃y∀x Read(x,y)),或者每个学生各读了一本(∀x∃y Read(x,y))。逻辑形式区分了这两种情况,自然语言把它们混在同一个句子里。逻辑连接词也是如此:自然语言中的「或」经常是排他性的(「茶还是咖啡?」),但逻辑中的 ∨ 是包含性的。这些不是偶然的缺陷。自然语言的首要功能是交流,歧义在交流中经常无害(语境可以消歧),但在推理中是致命的。
同时期的智者派也认识到了这一点。他们发展出 antilogikê(对立论证)的技术:对任何命题,都能用自然语言构造出正反两方面都有说服力的论证。Gorgias 在修辞学中明确主张,语言的力量在于说服,和求真无关,这当然是柏拉图极力攻击的。智者派的实践恰好说明了:自然语言的歧义不只是一种中性的属性,它可以被系统性地利用来使任何立场看上去都合理。逻辑系统存在的意义之一,就是堵住这个口子。
图:苏格拉底与高尔吉亚人(智者派)的辩论(AI生图)。
Frege 在 1879 年的《概念文字》(Begriffsschrift)中正式把逻辑从自然语言中剥离出来,建立了一套纯形式的推理系统。他的出发点正是上面这些缺陷:自然语言的歧义和冗余妨碍了严格推理,所以需要一套符号系统,其中每个表达式的意义完全由其结构决定。
维特根斯坦的前后期工作从两个不同的角度深化了逻辑与语言的关系,两个角度都和当代 LLM 有关联。
前期维特根斯坦在《逻辑哲学论》中的核心论题是:命题是事实的图像。一个命题和它所描绘的事态共享同一个逻辑形式,但逻辑命题是特殊的:它们的真值完全由结构决定,不依赖于世界中实际发生了什么。P ∨ ¬P 为真,不需要知道 P 是什么,也不需要去世界中查验任何东西。
但《逻辑哲学论》最深刻的洞察在于逻辑不能做什么。维特根斯坦写道:「可以显示的,不能被说出。」
举个例子。当你看到命题 aRb(a 和 b 之间存在关系 R),你一眼就能看出这是一个二元关系的结构:两个对象,一个关系。这个结构被命题显示出来了。但你没办法在命题内部写出另一个命题来声称 aRb 具有二元关系结构,因为这个声称本身又有一个结构,那个结构又需要被说明,无穷后退。
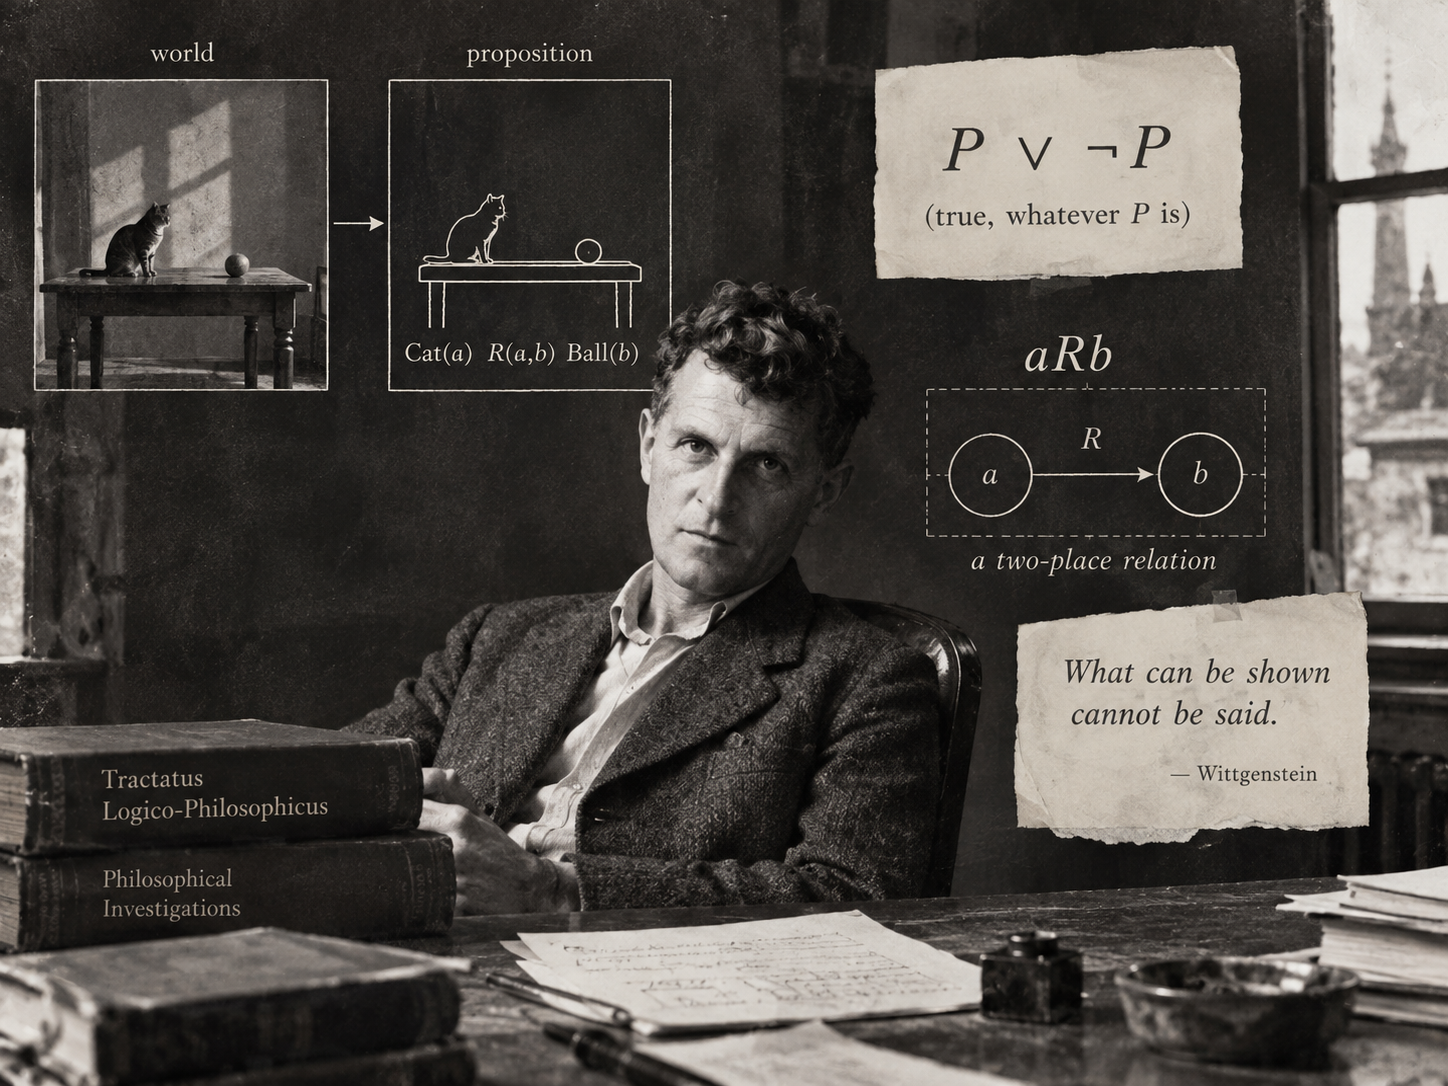
这对 LLM 意味着什么?LLM 能生成 aRb 这样的文本,因为训练数据里有大量类似模式。但 LLM 无法触及使 aRb 成为有意义表达的那个逻辑形式本身。它操作的始终是 token 序列(被说出来的东西),而不是使 token 序列有意义的结构(被显示但不能被说出的东西)。维特根斯坦从逻辑内部证明了有一类东西只能被显示、不能被说出。LLM 只处理被说出来的 token 序列,所以这一类东西在 LLM 的能力范围之外。
举个例子,三段论「所有 A 都是 B,x 是 A,所以 x 是 B」的有效性来自它的逻辑形式。这个形式被三段论的结构显示出来,但不能作为三段论的内容来陈述。LLM 能不能把握这个形式?Valentino et al. (2025) 分析了 LLM 的内部表征,发现逻辑有效性(validity)和语义合理性(plausibility)在模型的表征空间中高度对齐:模型把「推理是否有效」和「结论是否听起来合理」编码成了几乎同一个方向。后果是,当一个三段论逻辑有效但结论反常识时,模型倾向于判断它无效。模型在表征层面就分不开逻辑形式和语义内容。SemEval-2026 专门设立了一个共享任务 (Valentino et al., 2026) 来测量这个问题,结果显示内容效应在开源模型中普遍存在。这正好对应了维特根斯坦的判断:逻辑形式只能被显示、不能被说出,而一个只处理 token 序列的系统,在原理上有可能把两者混在一起。
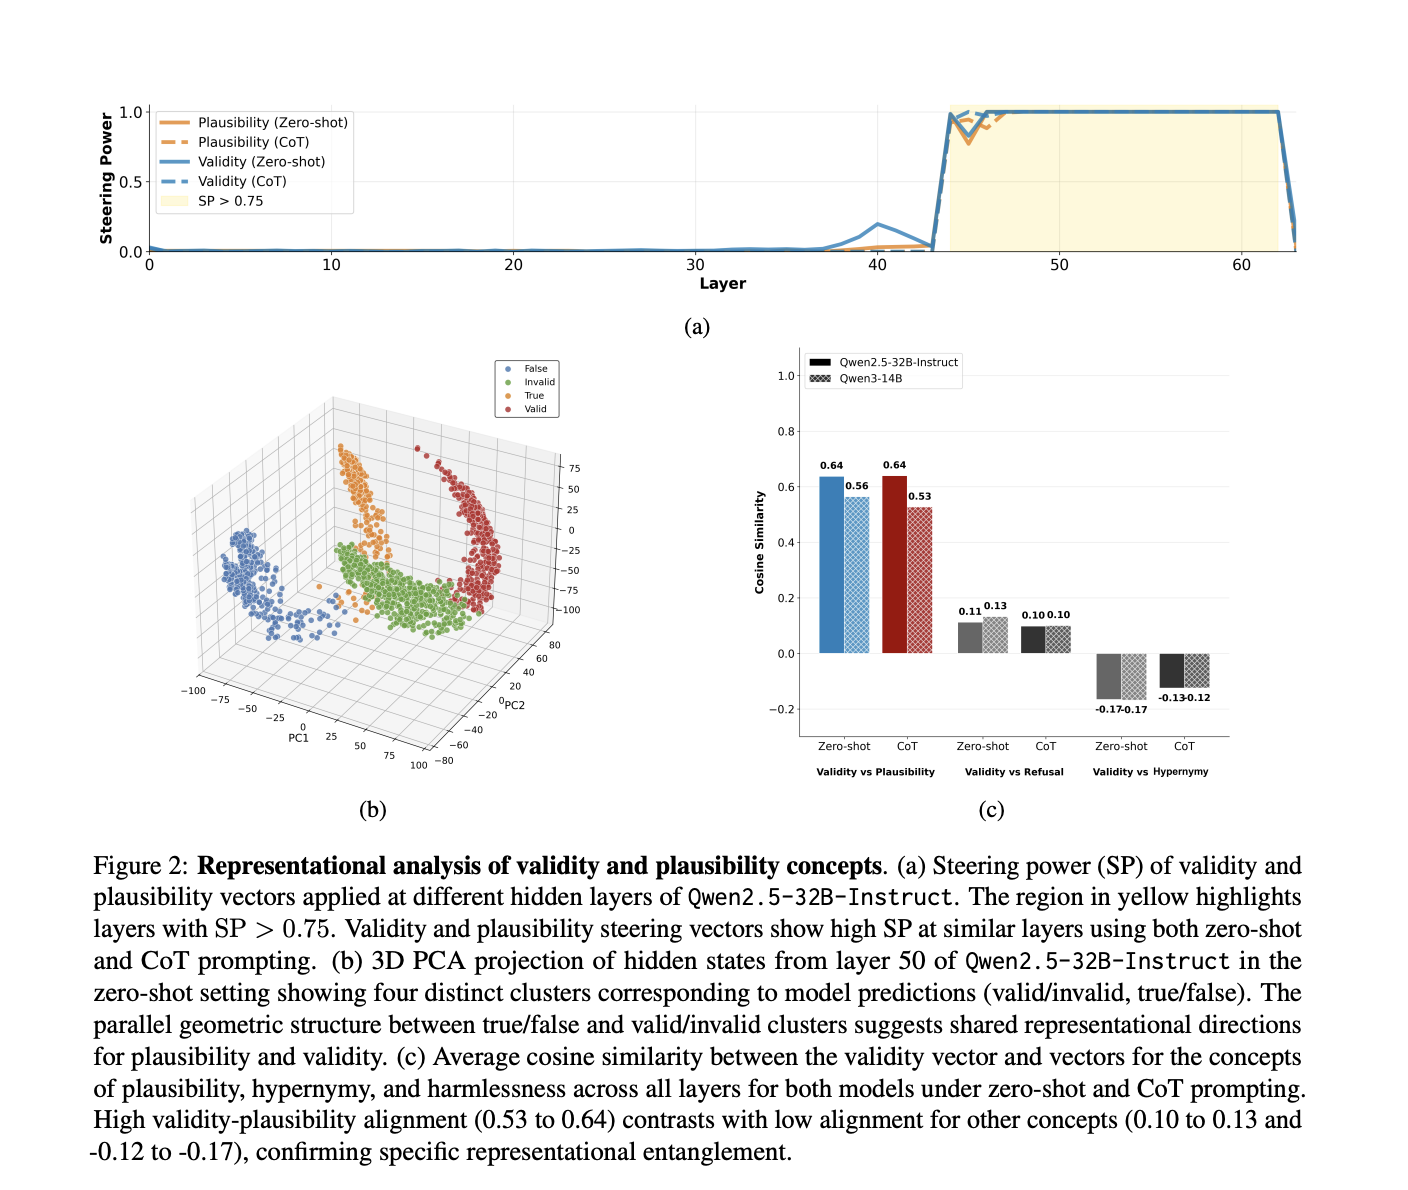
图:逻辑和语义的重合。
后期维特根斯坦在《哲学研究》中翻转了前期的几乎所有立场。他放弃了语言的图像理论,转而提出:词的意义就是它在语言游戏中的用法。语言游戏嵌套在生活形式中,理解一个词需要参与使用这个词的实践和活动。
这个转向和 LLM 的关系比乍看之下要密切得多。LLM 从海量文本中学到的,用维特根斯坦的术语来说,正是词语的用法模式:什么词在什么语境中出现、和什么词搭配、在什么对话结构中被使用。这在一定程度上暗合了意义即用法。但维特根斯坦坚持语言游戏嵌套在生活形式中:理解「疼」不仅需要知道这个词在什么句子里出现,还需要有过疼痛的经验,参与过关于疼痛的交流实践。LLM 观察到了语言游戏的文字记录,但没有参与产生这些记录的生活形式。
这和第一节的投影论证合流:文本是语言实践的投影,语言实践嵌套在具体活动中。LLM 从投影中学习,和投影源头之间隔了两层。
当然,逻辑类智能的发展甚至是最早的。shell 里的一行命令 grep | sort | uniq -c | sort -rn 是一个管道:过滤、排序、计数、再排序,每个环节执行一个离散的、确定性的操作,环节之间通过标准化的文本接口传递中间结果。这个管道不需要任何语言模型,但它执行的操作和逻辑推理中的基本步骤同构:从一个集合中按条件筛选,对结果排序,对重复项计数,按计数重排。SQL 查询是同一类操作的另一种表达。Unix 管道的设计者不会把这叫做智能,但它蕴含的能力(组合、排序、过滤、聚合)恰好落在逻辑这一类里。
3. 图像智能
这一类智能处理的信息有一个共同特征:表征中的每一个物理属性都携带意义,无法在不丢失信息的情况下转换为离散符号。
图像会携带自明信息
潘诺夫斯基(Panofsky)在图像学方法中区分了三个层次。第一层(前图像志,pre-iconographic)是直接感知的内容:一个男人举起帽子。看到就知道,不需要任何文化知识或符号系统的中介。第二层(图像志,iconographic)是约定性的含义:这个姿势是在打招呼。这需要特定文化的知识。第三层(图像学,iconological)是深层的文化症候:这个打招呼方式反映了某个时代的社会等级观念。到达第三层需要 Panofsky 所说的综合直觉(synthetic intuition),一种跨领域的、整体性的理解能力。
瓦尔堡(Warburg)的研究揭示了另一种自明性。他追踪了一些情感姿态在几千年间的图像中反复出现:痛苦的扭曲、胜利的昂首、哀悼的俯身。他把这些称为 Pathosformel(激情程式)。这些姿态不经过文字记载就能跨越世纪传递情感意义。一个从未读过古希腊文献的人看到拉奥孔群像,仍然能感受到痛苦。这种信息传递完全绕过了语言。
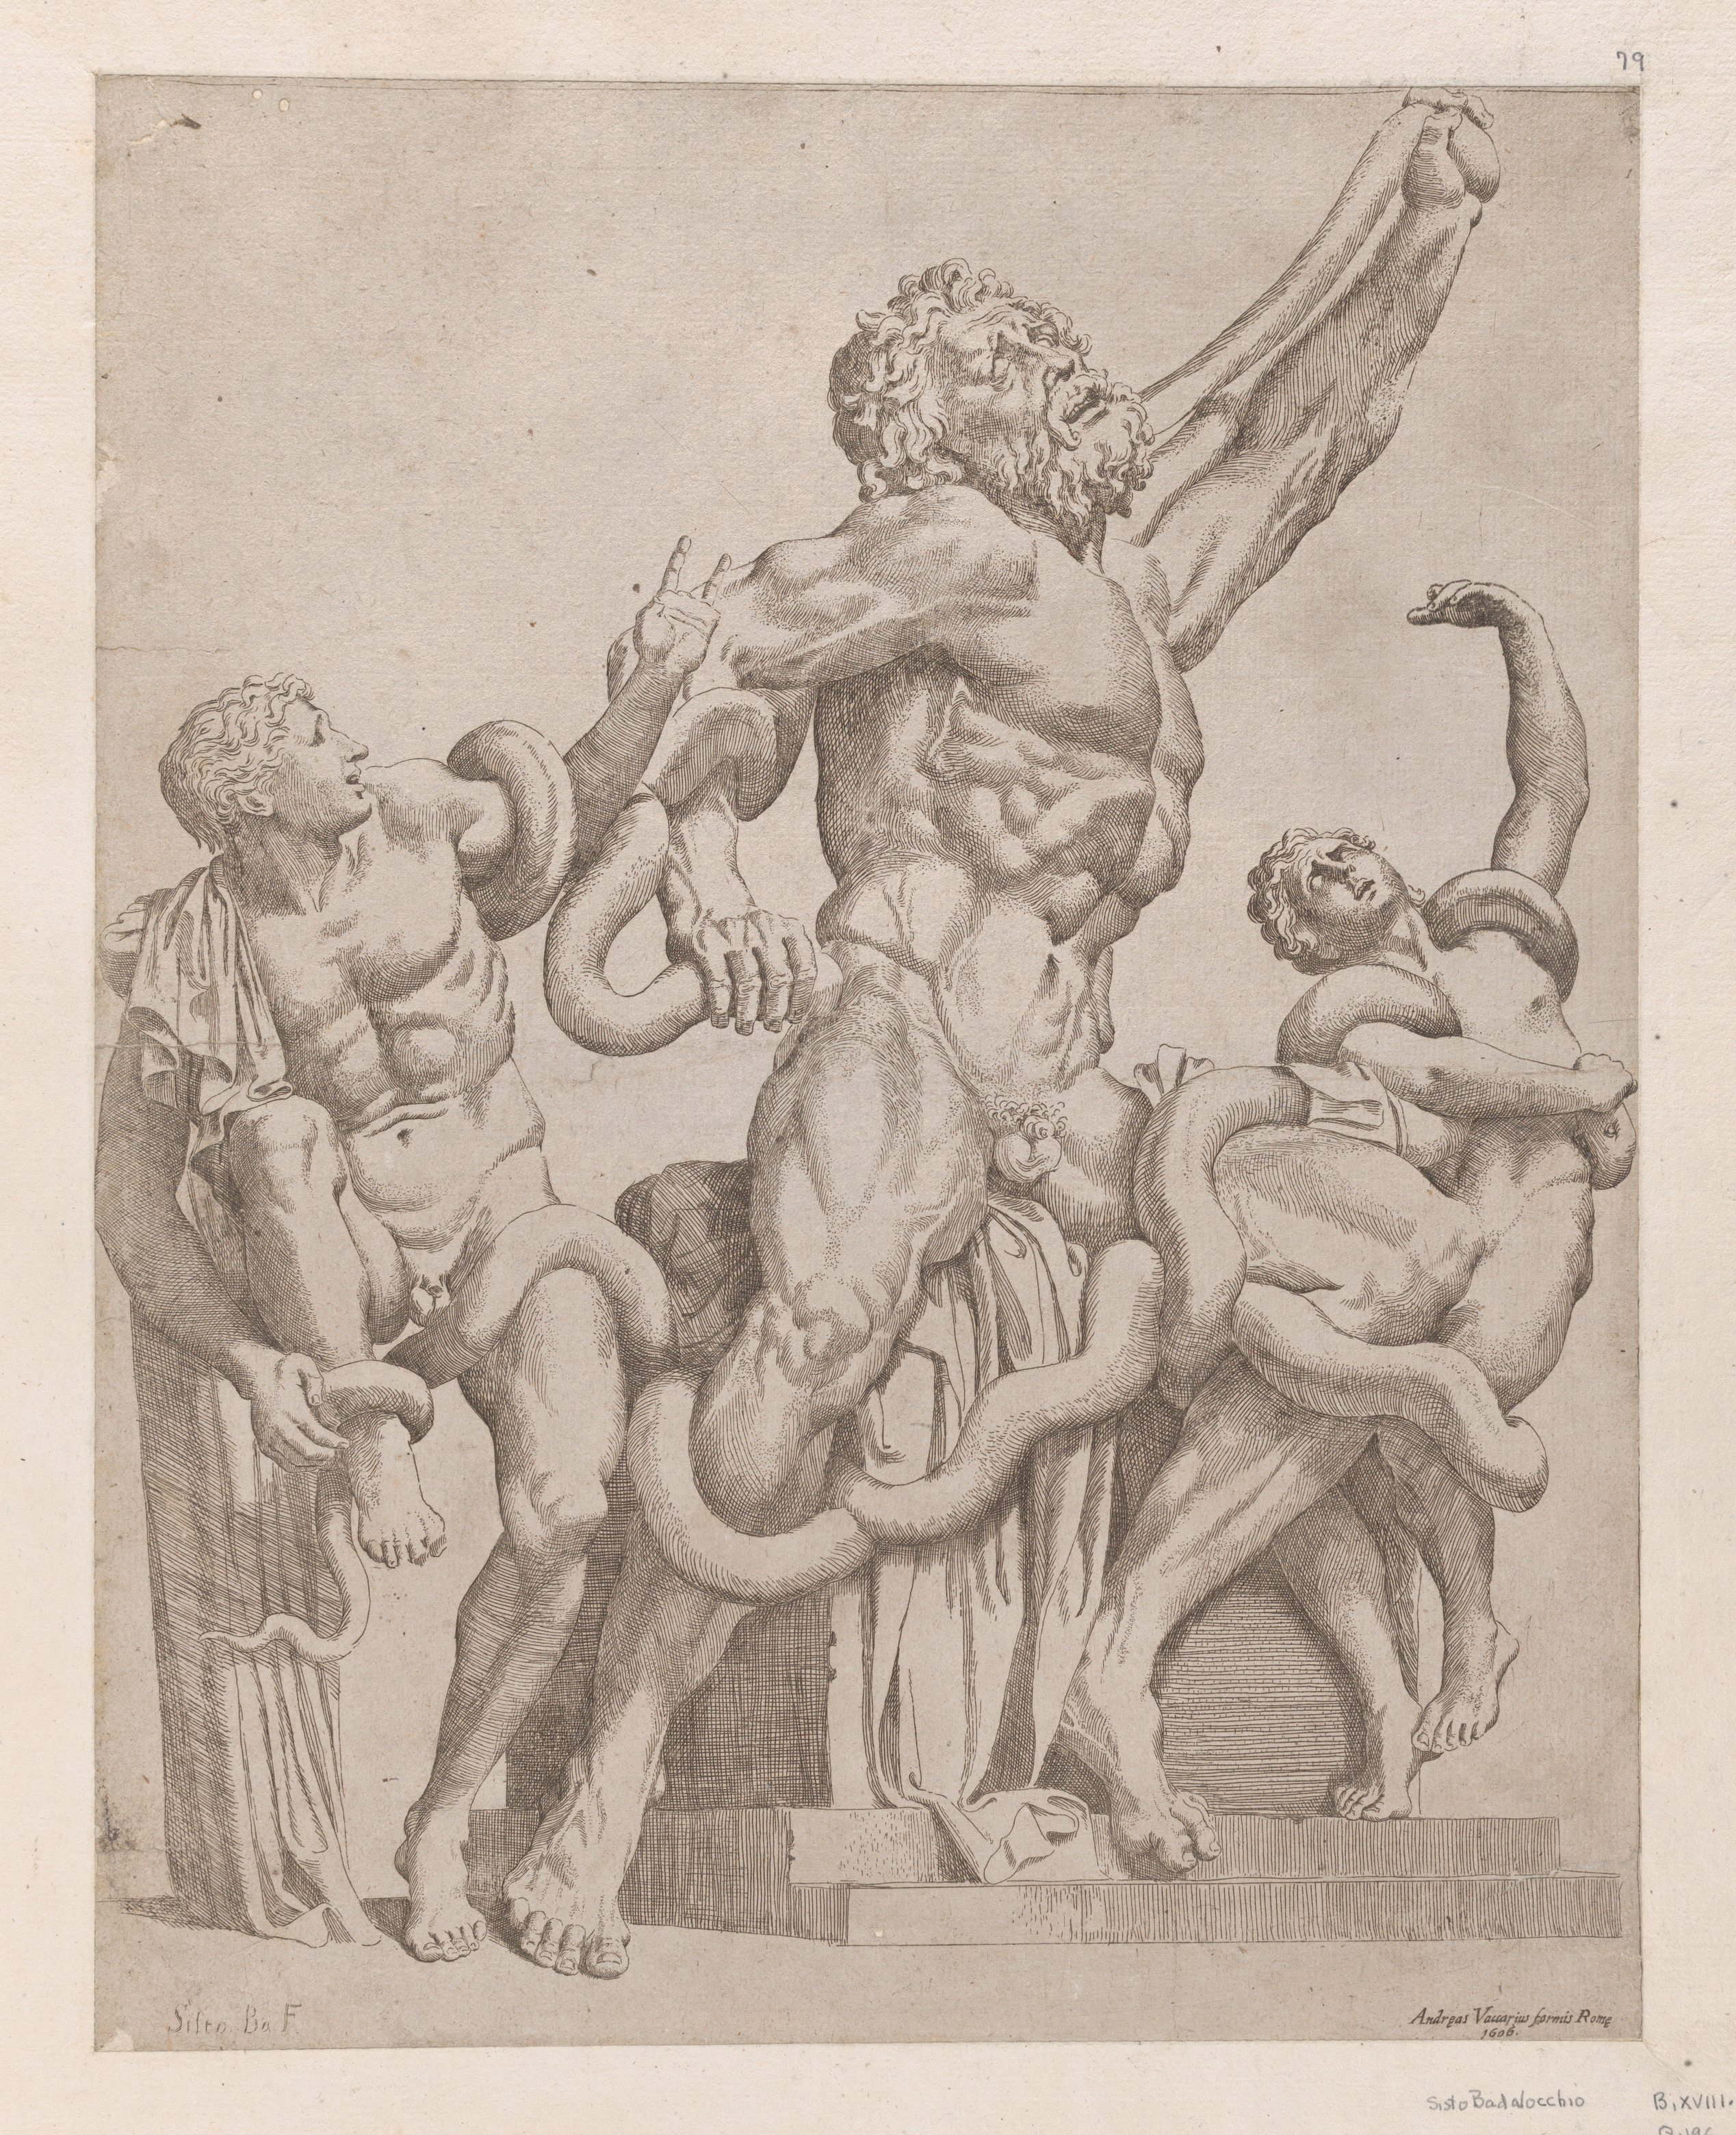
图:Sisto Badalocchio,拉奥孔。此处用于指认文本所说的拉奥孔群像与痛苦姿态。
这个现象不限于古典艺术。日常生活中到处都是同样的结构:一张人脸照片里的微表情(嘴角微微下拉、眉心轻微收紧),你一看就知道这个人不高兴,但要用文字精确描述这种不高兴的程度和类型,需要大量的词语,描述完之后读者仍然不如直接看一眼照片来得准确。新生儿还不会说话,已经能分辨母亲的笑脸和怒脸 (Field et al., 1982),这种辨别先于任何语言能力存在。产品设计中的视觉语言也是如此:一个红色的警告按钮传达紧迫感,一个圆角矩形传达安全感,用户不需要阅读文字说明就能接收到这些信号。
潘诺夫斯基和瓦尔堡的理论揭示的结构性事实和宗教或古典题材无关。他们证明了:存在一整类信息,它们在图像中是自明的(看到就知道),在语言中需要大量描述才能近似传达,而且传达之后仍然丢失了原有的内容。这是一个结构问题,和描述的长度无关。
图像会携带拓扑结构
图像携带的另一类语言难以编码的信息是拓扑结构:空间中的连接关系、包含关系、邻接关系。拓扑学关注的是这些关系在连续变形(拉伸、弯曲,但不撕裂、不粘合)下是否保持不变。
Harry Beck 在 1931 年设计伦敦地铁图时,刻意放弃了地理上的精确比例,只保留了站点之间的连接关系和线路的拓扑结构。这张图大幅压缩和拉伸了实际距离,但完整保留了乘客需要的核心信息:从 A 站到 B 站需要换几次线、在哪站换乘、哪些线路在哪些站点交汇。
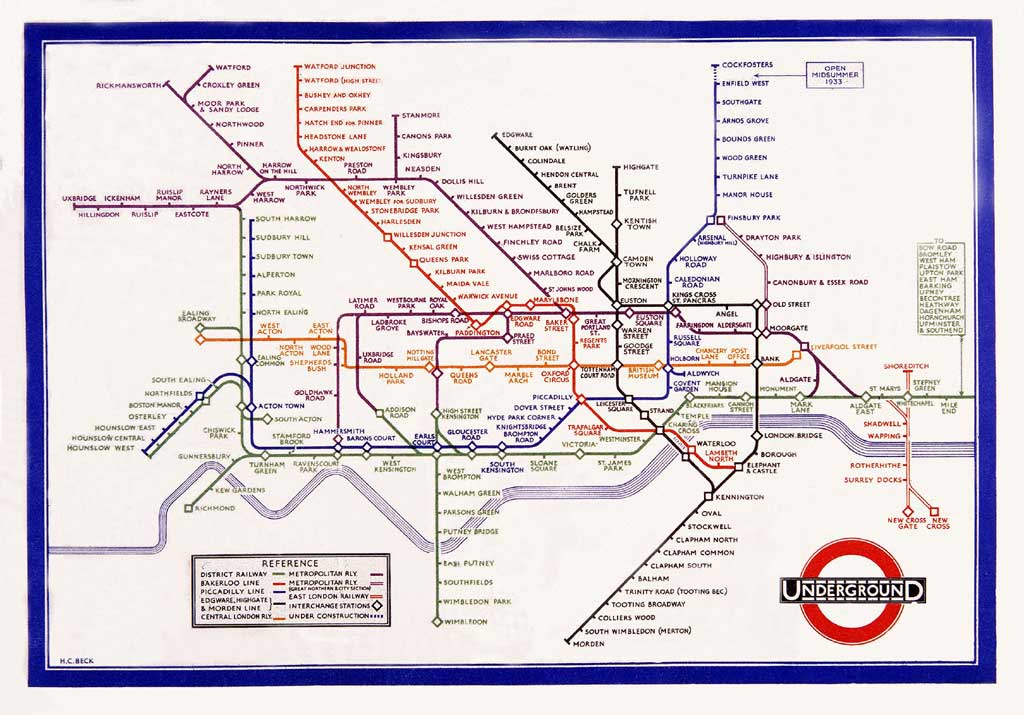
图:Harry Beck,1933 年伦敦地铁。图例显示的是拓扑线路与换乘关系,不是按实际距离绘制的地理图。
用自然语言描述同样的信息需要为每一对可能的起终点写出换乘路径。而且写完之后读者仍然无法一眼看出全局的连通性:地图上一眼就能看到 Northern Line 和 Central Line 在 Bank 站交汇,但这条信息在文字中分散在多条换乘描述里。
更一般地说,任何涉及多个元素之间同时关系的信息(电路图、分子结构、建筑平面图),图像都能以全局同步的方式呈现:所有元素和它们之间的关系同时在场,观看者可以自由选择关注哪一对关系。语言只能逐条描述,读者需要自己在脑中重建全局结构。而这个重建过程本身就依赖空间想象能力,这种能力不属于语言。
当然,仅在 LLM 领域内,也会出现语料耗尽的危险。公开可用的高质量文本数据(书籍、论文、代码、网页)的总量是有限的,模型性能对数据量的依赖遵循 scaling law,收益递减。合成数据是一条尝试中的出路,但面临分布坍缩的风险:合成文本比例过高时,模型会逐渐丢失真实数据中的多样性。
目前的探索到哪一步了?
1. 隐式推理与 JEPA
隐式推理就在试图绕过自然语言的瓶颈:让模型在连续的表征空间中直接计算,不经过 token 化。
Transformer 的每一层处理完输入后,会产生一个hidden state,这个隐藏状态有数千到数万个维度,每个维度是一个浮点数。如果模型可以在这个空间中进行多步计算,而不需要在每一步都把结果压缩成一个 token,它的计算带宽会大幅增加。这就是隐式推理的核心思路。
具体做法之一是引入循环深度(recurrent depth):让同一组 transformer 层反复运行多次,每次的输入是上一次的输出。这样做等于在不增加参数量的情况下增加了计算深度。LOTUS (Fan et al., 2026)、LoopLM (Zhu et al., 2025) 等工作沿这个方向取得了一些进展。但截至 2026 年中,实验显示模型在没有中间监督信号的情况下最多能有效利用约 7 步的隐式规划。超过这个深度,额外的计算不再带来性能提升。
JEPA(Joint Embedding Predictive Architecture)是 LeCun 提出的另一个尝试,侧重感知层面。传统的遮蔽自编码器 (MAE, He et al., 2022) 从部分输入重建完整的像素。JEPA 不重建像素,而是在一个抽象的表征空间中做预测:给定一张图像一部分区域的表征,预测另一部分区域的表征。这样做的好处是模型不需要花容量去记住不可预测的细节(具体的像素值、纹理噪声),而是集中在可预测的结构性信息上。
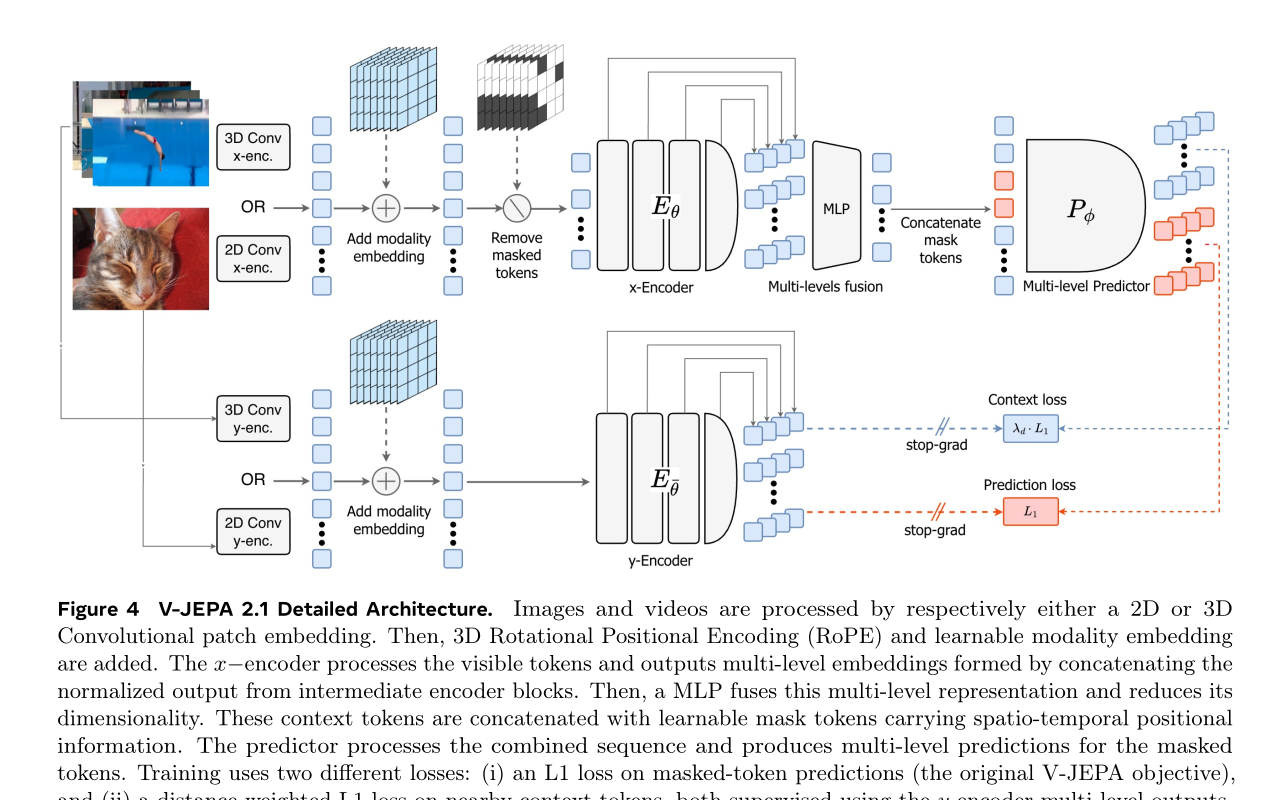
图:V-JEPA 2.1 Detailed Architecture,原论文 Figure 4 裁切;Mur-Labadia et al., 2026。x-encoder 处理可见 token,predictor 在表征空间预测被遮蔽 token。
隐式推理和 JEPA 都在尝试让模型在非语言的表征空间中操作,但目前进展有限。以 I-JEPA (Assran et al., 2023) 为例,ViT-L(约 3 亿参数)到 ViT-H(约 6 亿参数),ImageNet 线性探测准确率的提升只有约 2 个百分点(约 77% 到约 79%)。JEPA 系列在持续迭代,V-JEPA 2 (Assran et al., 2025) 和 V-JEPA 2.1 (Mur-Labadia et al., 2026) 在视频理解上有明显进展,但总体而言,这类架构的参数效率和语言模型的 scaling law 相比仍有差距。方向在推进,距离实用还有路要走。
2. Jev 与中间地带
从 shell 命令到大语言模型,智能的确定性和灵活性之间有一整条谱。Shell 命令在确定端:输入确定、输出确定、行为完全可预测,但不接受自然语言输入,不能处理歧义。大语言模型在灵活端:接受任意自然语言输入、输出任意自然语言文本,但行为不完全可预测,校准也不可靠。
今年以来,越来越多的业务从大模型切换到小模型。这既是成本压力下的现实选择,也反映了人对控制力的渴望:希望模型的输出可预测、可校验、可问责。
Jev 填补的是纯代码和小模型之间的空隙。它接受自然语言输入(不需要写代码来定义规则),但输出完全结构化的内容(概率分布,不需要从自然语言中解析结果)。它不需要训练数据(零样本),但它的行为比生成式模型更可预测。
在第一节的实测中已经看到,Jev 和 DeepSeek 判断准确率持平(0.586),但 Jev 的概率质量更好(ECE 0.205 vs 0.350),延迟快约 4.5 倍。准确率打平的条件下,Jev 给出了更可信的置信度和更快的响应。对于需要控制力的业务场景,这两点的价值比准确率的微小差异大得多。
这个位置的意义超出了工程效率。它表明,在判断这一类智能操作中,我们不需要经过完整的语言生成过程。模型可以在内部表征空间中完成计算,直接输出结构化结果。Jev 选择了一种更适合判断任务的智能形式,这个选择带来了概率质量和延迟上的系统性优势。
3. 整合
判断需要离散的分类和评估,图像智能需要连续的、整体的表征。但很多真实的认知任务需要两种能力协作。医生读 X 光片时,从图像中提取视觉证据,然后应用诊断规则更新疾病概率。建筑师看平面图时,理解空间布局和承重关系,然后计算具体的结构参数。这些任务不能只用一种表征完成。
这些形式之间如何整合?Carruthers 提出过一个假说:语言在认知中的作用是充当中央总线,连接不同的认知模块,让信息在模块之间流动。但这个假说有一个前提:语言能够无损地传递其他模块的信息。如果语言是有损投影(第一节的论证),那把它当作总线就意味着所有模块之间的通信都要经过一个有损的中介,每次传递都丢失图像和空间维度的内容。
也许整合应该发生在一个更底层的连续表征空间中。在这样一个空间中,离散信息和连续信息可以共存,不需要经过语言的中转。这正是隐式推理和 JEPA 正在探索的方向:建立一个足够高维的连续空间,让不同类型的表征在其中协同工作。
如何构建这样一个空间?如何让逻辑推理、语言表达和视觉感知在其中协同?或许我们可以沿着 Jev 的思路继续想下去。
引用论文
- Valentino, M., Kim, N., & Freitas, A. (2025). How language models conflate logical validity with plausibility: A representational analysis of content effects. arXiv preprint arXiv:2510.06700. Published in Findings of ACL 2026.
- Valentino, M., et al. (2026). SemEval-2026 Task 11: Disentangling content and formal reasoning in large language models. Proceedings of the 20th International Workshop on Semantic Evaluation (SemEval-2026).
- Fan, Y., Svete, A., & Lee, K. (2026). Bridging the gap between latent and explicit reasoning with looped transformers. arXiv preprint arXiv:2606.31779.
- Mur-Labadia, L., Muckley, M., Bar, A., et al. (2026). V-JEPA 2.1: Unlocking dense features in video self-supervised learning. arXiv preprint arXiv:2603.14482.
- Zhu, R.-J., Wang, Z., Hua, K., et al. (2025). Scaling latent reasoning via looped language models. arXiv preprint arXiv:2510.25741.